สปริงไอโอวา: เอกสาร RAG | เจฟ ด็อก | สาธิต
ในบทความก่อนหน้านี้ เราได้แนะนำ Spring AI TypeSafe และโมเดล Jev: พิมพ์คำถาม ตัวเลขที่ปรับเทียบ ในเวลาไม่กี่ร้อยมิลลิวินาที หนึ่งบรรทัดในตาราง SPI ในบทความนั้นสมควรได้รับโพสต์ของตัวเอง JevDocumentFilter และ JevDocumentReranker พวกเขาเป็น DocumentPostProcessors หมายความว่าเชื่อมต่อโดยตรงกับ Spring AI RAG โมดูลาร์ ท่อส่งก๊าซ
บทความนี้นำทั้งสองมารวมกัน การเรียก LLM สองครั้งช่วยล้างและเพิ่มคำถามของผู้ใช้ก่อนที่จะดึงข้อมูล จากนั้น Jev จะประเมินแต่ละชิ้นที่ได้รับมาก่อนที่จะได้รับข้อความแจ้ง ไปป์ไลน์ทั้งหมดเป็นผู้สร้างที่ปรึกษา
💡 สาธิต: ตัวอย่างที่สมบูรณ์คือ
05-1-modular-ragโมดูล มันอยู่ประตูถัดไป05-ragเวอร์ชันไร้เดียงสา ดังนั้นคุณจึงสามารถแยกความแตกต่างระหว่างทั้งสองได้ ผลงานแต่ละรายการที่อ้างถึงด้านล่างมาจากการแสดงสด
เหตุใด Naive RAG จึงขาดตลาด
การสาธิต Spring AI RAG แบบคลาสสิกคือ QuestionAnswerAdvisor ในร้านเวกเตอร์ โดยจะรวมข้อความของผู้ใช้ ค้นหาส่วนที่คล้ายกัน และวางไว้ในข้อความแจ้ง สิ่งนี้ได้ผลบนเวทีและไม่เสถียรในชีวิตจริง ด้วยเหตุผลสามประการ:
- ผู้ใช้ไม่พิมพ์คำค้นหา พวกเขาพิมพ์ “ฉันอาศัยอยู่ในฟลอริดาและได้ยินมามากมายเกี่ยวกับพายุเมื่อฤดูใบไม้ร่วงที่แล้ว มิลตันโจมตีรัฐของฉันจริง ๆ หรือไม่และที่ไหน?” การผสมผสานสิ่งนี้เข้ากับการค้นหาอย่างแท้จริง
- คล้ายกันไม่มีประโยชน์เหมือนกัน ร้านค้าเวกเตอร์ส่งคืนชิ้นส่วนที่เป็น บน หัวข้อ รายการข้อมูลอ้างอิงที่กล่าวถึง “เฮอริเคนมิลตัน” ห้าครั้งมีคะแนนสูงและไม่ตอบอะไรเลย
- ข้อความที่ดึงมานั้นเป็นอินพุตที่ไม่น่าเชื่อถือ ทุกอย่างในเอกสารของคุณจะตรงไปที่ข้อความแจ้ง รวมถึงข้อความที่เขียนเพื่อแย่งชิงเทมเพลต
เราจะตอบคำถามนี้ในรูปแบบ PDF จากวิกิพีเดียเกี่ยวกับพายุเฮอริเคนมิลตัน และแก้ไขปัญหาแต่ละข้อด้วยส่วนประกอบที่เสียบได้
Modular RAG ใน Spring AI
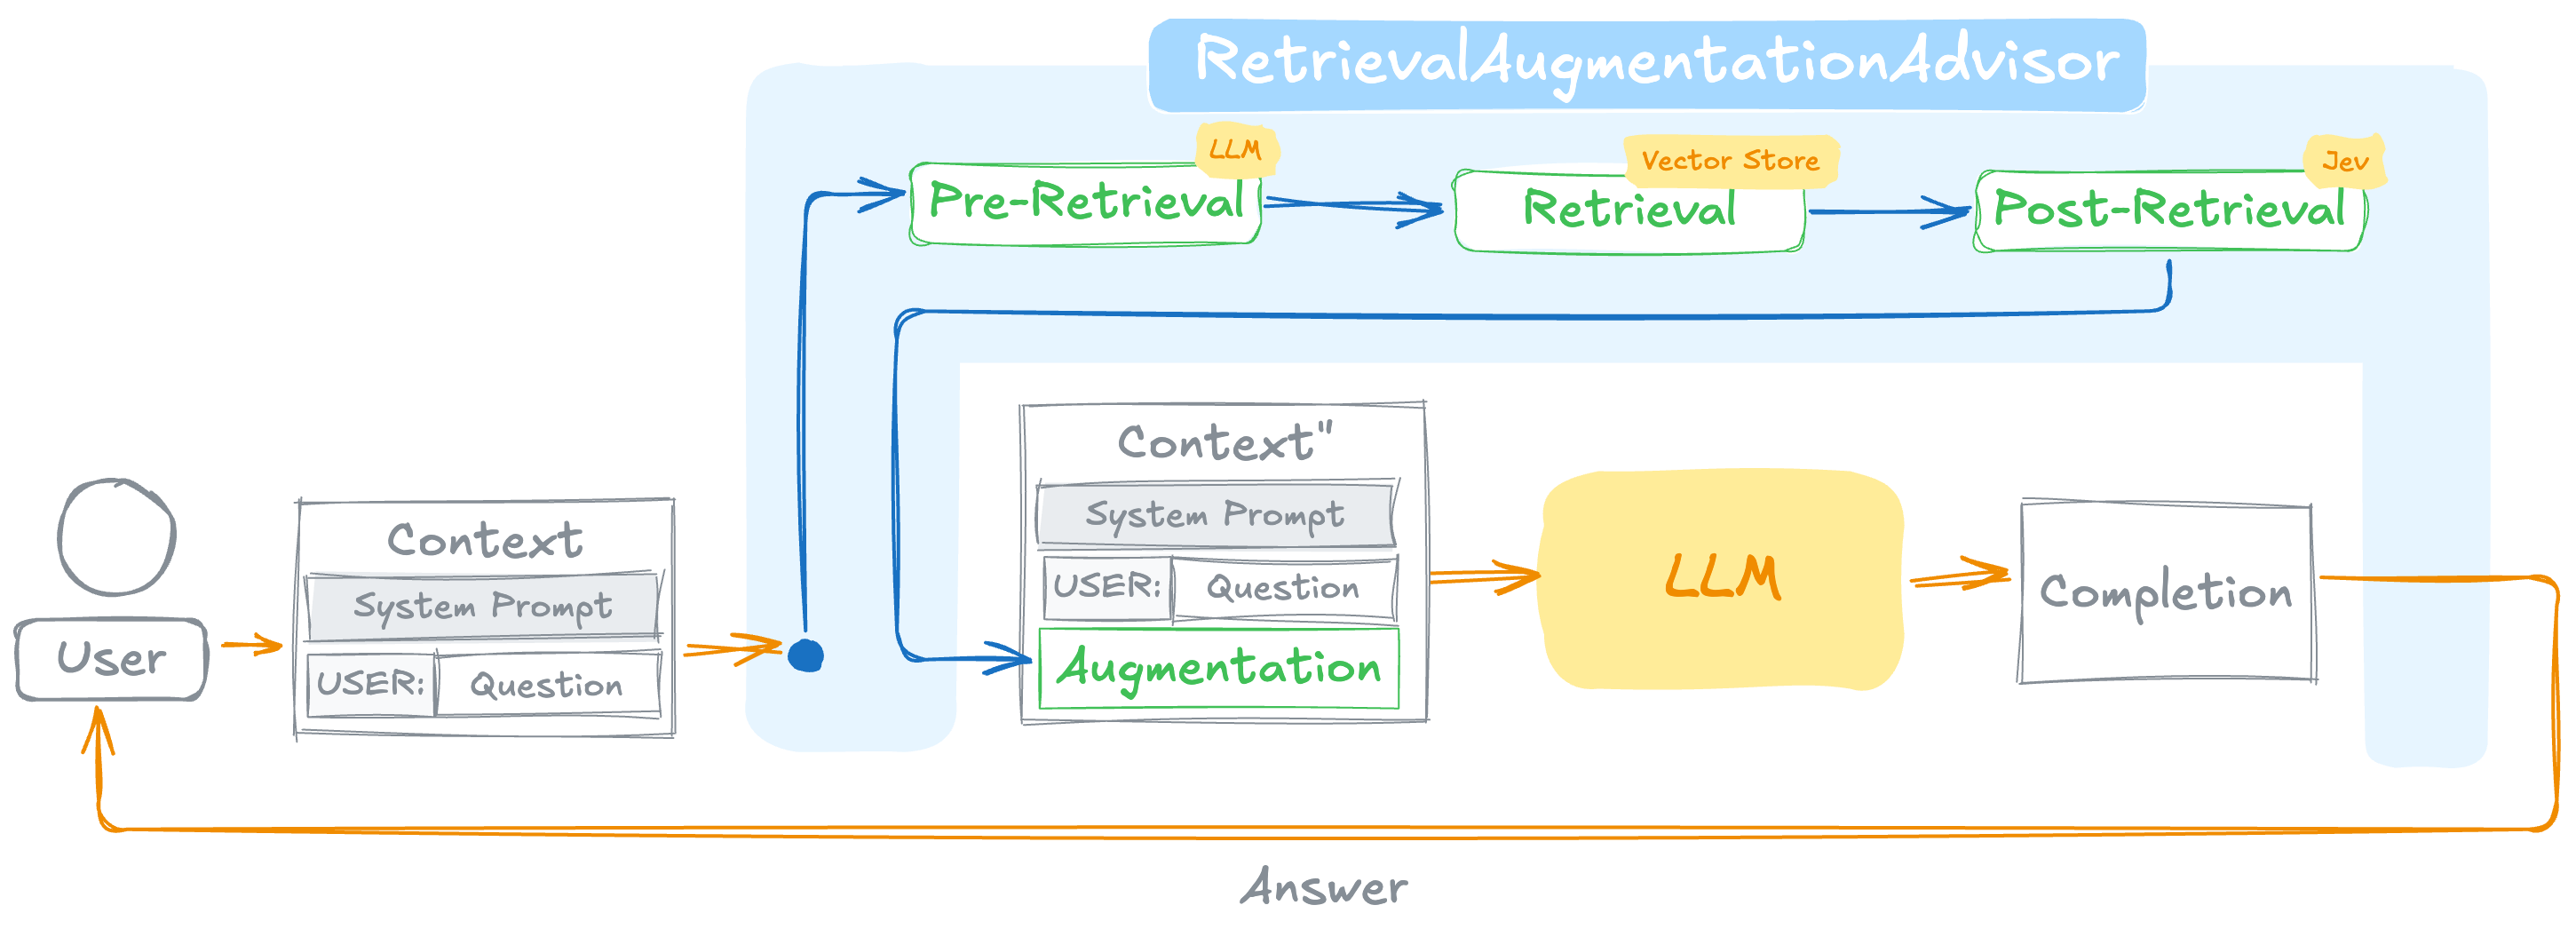
ที่ RetrievalAugmentationAdvisorของ spring-ai-rag ใช้สถาปัตยกรรมที่อธิบายไว้ใน Modular RAG: การแปลงระบบ RAG ให้เป็นโครงสร้าง LEGO-Like ที่กำหนดค่าใหม่ได้ จากภายนอก เป็นเพียงที่ปรึกษาอีกรายหนึ่ง โดยอยู่ระหว่างพรอมต์และโมเดล ดำเนินการขั้นตอนการดึงข้อมูล และแนบผลลัพธ์ไปกับข้อความของผู้ใช้ ข้อความแจ้งของระบบและคำถามผ่านไปครบถ้วน
ภายในแต่ละขั้นตอนจะมีอินเทอร์เฟซขนาดเล็กที่คุณสามารถสลับได้:
| เฟส | อินเทอร์เฟซ AI ของฤดูใบไม้ผลิ | งาน | ใช้ในการสาธิตนี้ |
|---|---|---|---|
| ก่อนการฟื้นตัว | QueryTransformer |
เขียนแบบสอบถามใหม่ให้ดีขึ้น | RewriteQueryTransformer |
| ก่อนการฟื้นตัว | QueryExpander |
แปลงหนึ่งแบบสอบถามเป็นหลาย ๆ | MultiQueryExpander |
| การกู้คืน | DocumentRetriever |
ค้นหาเอกสารเพื่อขอคำปรึกษา | VectorStoreDocumentRetriever |
| การกู้คืน | DocumentJoiner |
รวมผลลัพธ์จากแบบสอบถามทั้งหมด | ConcatenationDocumentJoiner (มาตรฐาน) |
| หลังการกู้คืน | DocumentPostProcessor |
กรอง จัดประเภทใหม่ หรือบีบอัดเอกสาร | JevDocumentFilter, JevDocumentReranker |
| รุ่น | QueryAugmenter |
ใส่บริบทและคำถามในพรอมต์ | ContextualQueryAugmenter |
นี่คือขั้นตอนการโทรทั้งหมด:
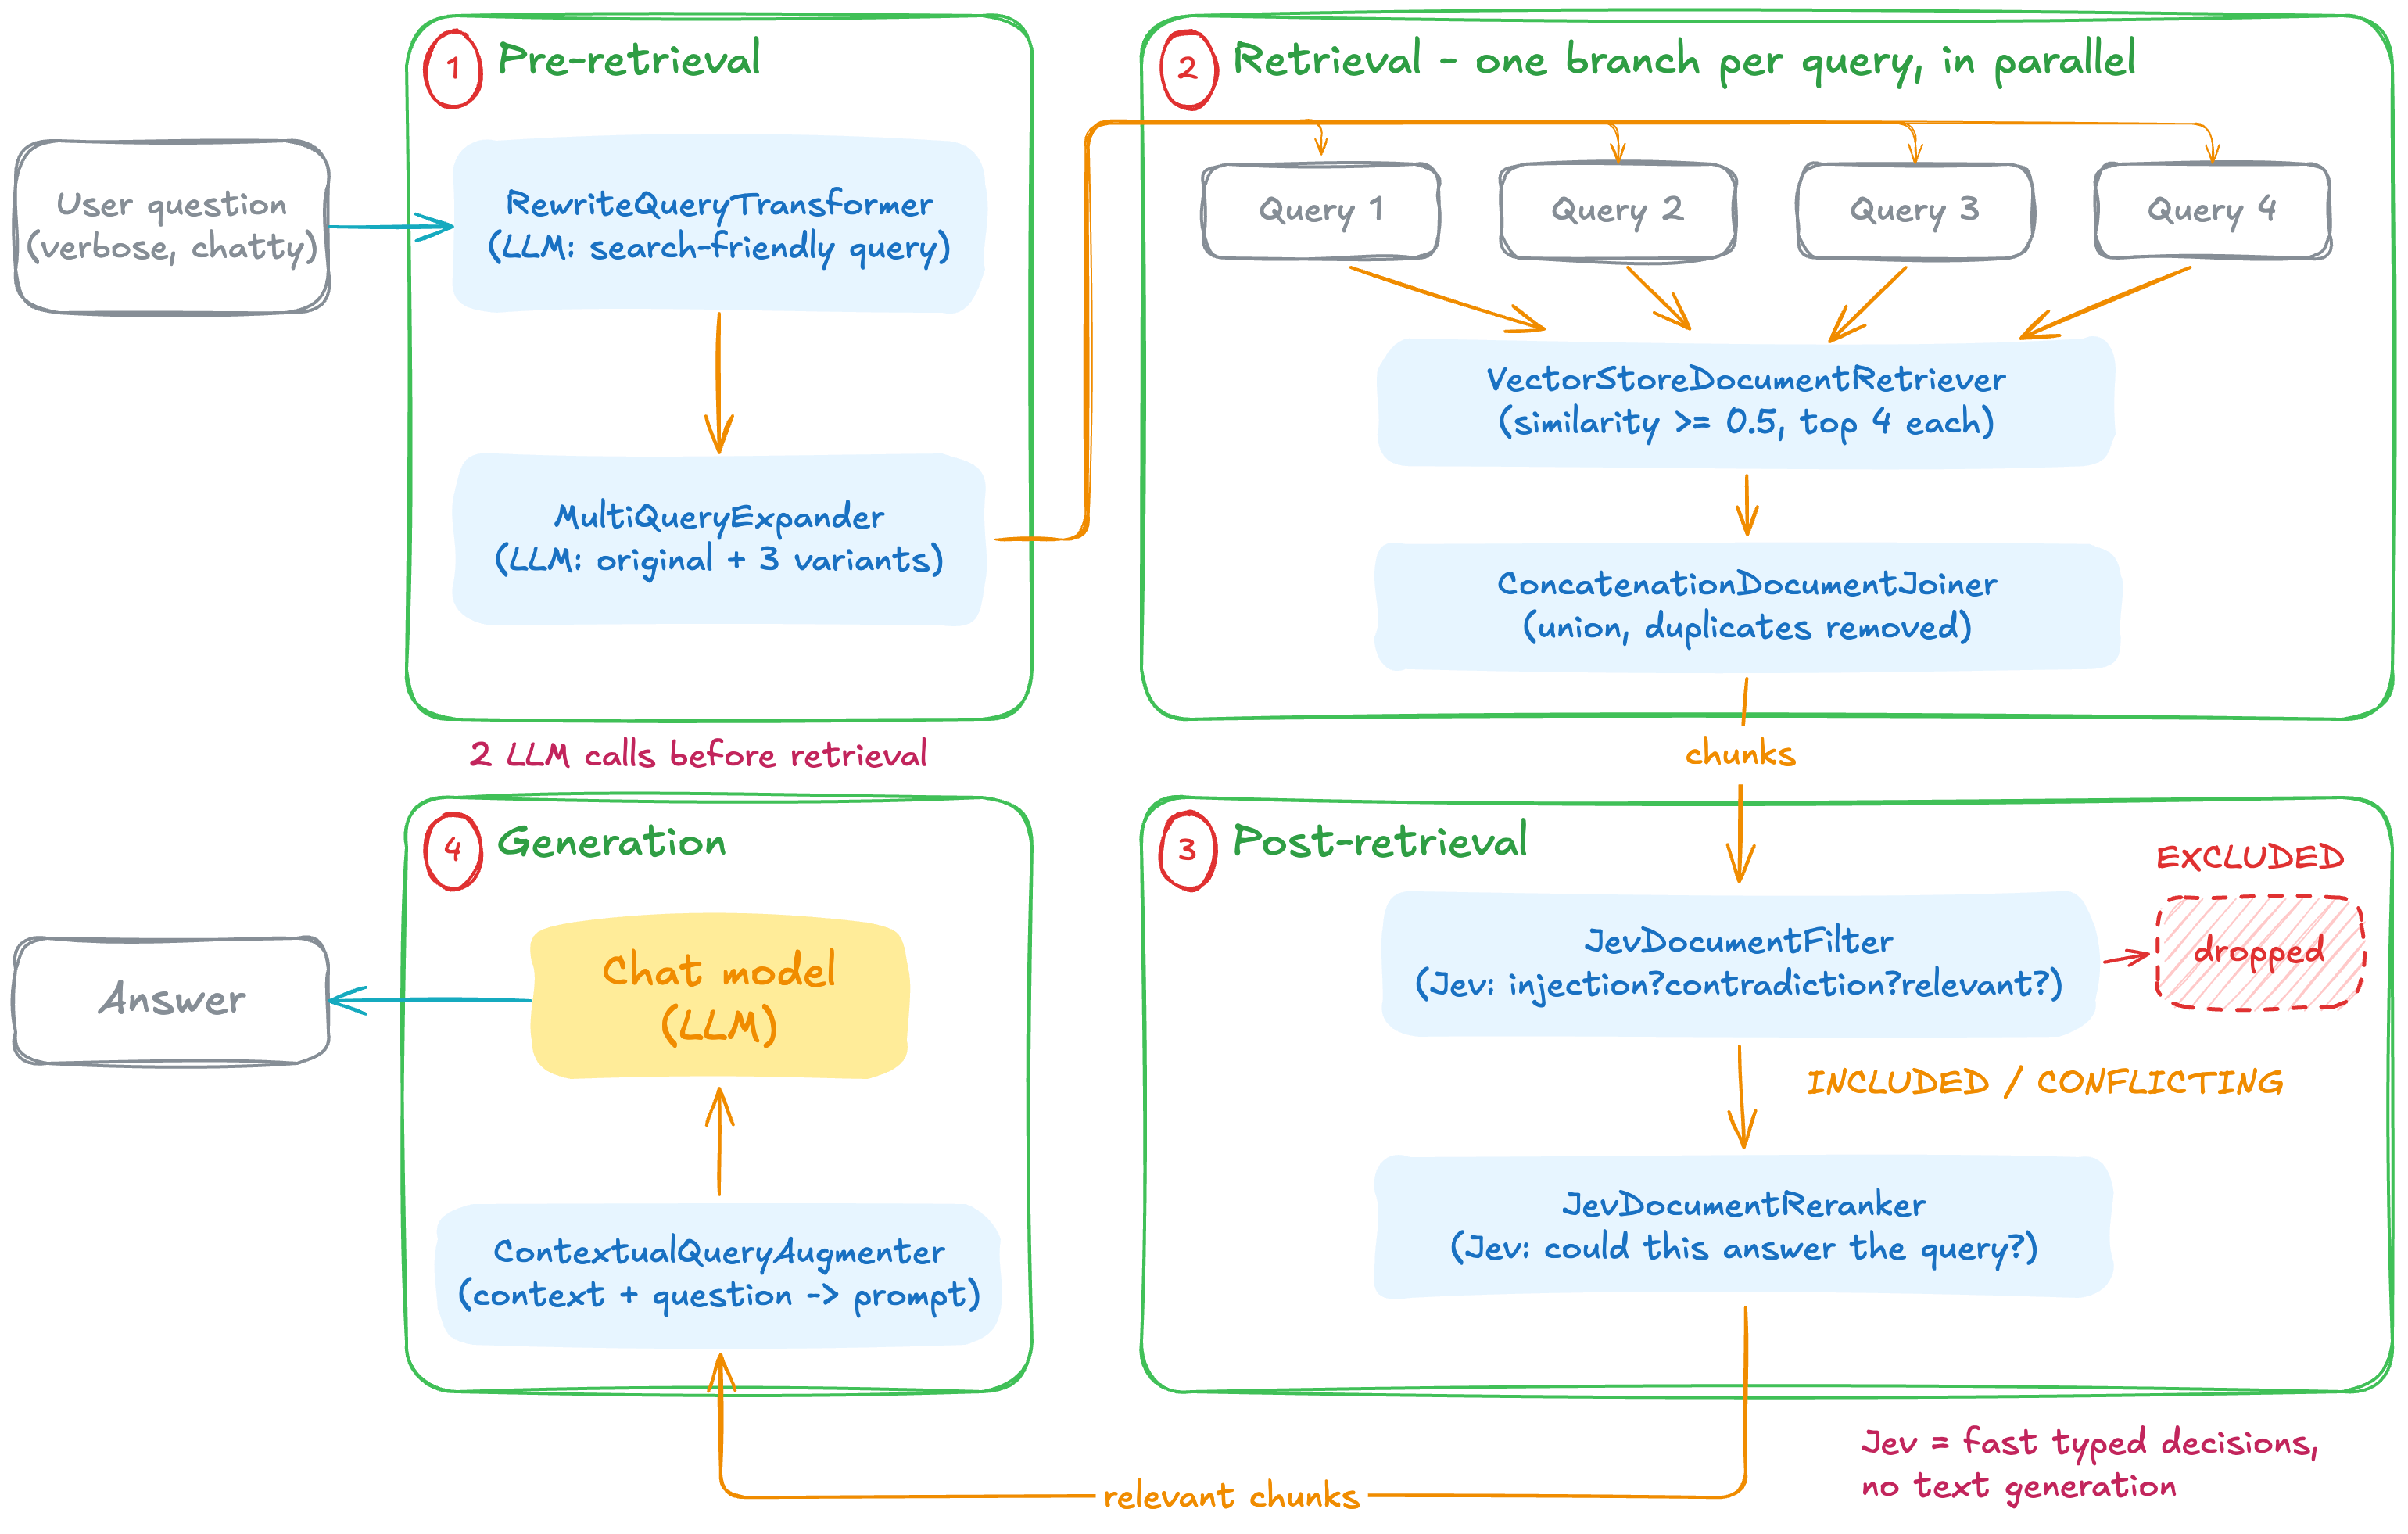
แบรนช์การกู้คืนจะทำงานแบบคู่ขนาน หนึ่งรายการต่อการสืบค้น และเชื่อมต่อเข้าด้วยกันก่อนการประมวลผลภายหลัง สังเกตรายละเอียดที่ละเอียดอ่อน: โพสต์โปรเซสเซอร์และเครื่องมือเสริมมองเห็นผู้ใช้ ต้นฉบับ คำถามไม่ใช่การเขียนซ้ำ การเขียนซ้ำมีไว้เพื่อปรับปรุงการค้นหาเท่านั้น
เริ่มต้นใช้งาน
เพิ่มโมดูล Spring AI RAG และสิ่งประดิษฐ์ TypeSafe สองรายการจากบทความก่อนหน้า Spring AI BOM จัดการสิ่งแรก:
    org.springframework.ai
    spring-ai-rag


    org.springaicommunity
    spring-ai-starter-typesafe
    0.3.0


    org.springaicommunity
    typesafe-spring-ai
    0.3.0
สตาร์ทเตอร์จะตั้งค่า a โดยอัตโนมัติ TypeSafeClient bean จากคีย์ API ของคุณ:
spring.ai.typesafe.api-key=${TYPESAFE_API_KEY}
การสาธิตยังใช้ spring-ai-pdf-document-reader สำหรับการกลืนกินและ spring-ai-starter-model-transformers สำหรับการจัดตั้งบริษัทในท้องถิ่น
ท่อส่งก๊าซ
การนำเข้าจะเหมือนกับแอปพลิเคชัน Spring AI RAG ใดๆ: อ่าน PDF แบ่งเป็นชิ้นๆ และจัดเก็บ
vectorStore.add(
    TokenTextSplitter.builder().build().split(
        new PagePdfDocumentReader(hurricaneDocs).read()));
ส่วนที่น่าสนใจคือตัวสร้างตัวเดียว ความคิดเห็นที่มีหมายเลขกำกับแต่ละรายการคือบล็อกของไดอะแกรม:
// Separate builder for the LLM-backed stages, so they don't inherit the main client's advisors
var ragClientBuilder = chatClientBuilder.clone();

var modularRag = RetrievalAugmentationAdvisor.builder()
    // 1. Pre-retrieval: rewrite the chatty question into a search-friendly query
    .queryTransformers(RewriteQueryTransformer.builder()
        .chatClientBuilder(ragClientBuilder)
        .build())
    // 2. Pre-retrieval: expand it into several diverse queries (original included)
    .queryExpander(MultiQueryExpander.builder()
        .chatClientBuilder(ragClientBuilder)
        .numberOfQueries(3)
        .build())
    // 3. Retrieval: similarity search per query; the default joiner dedups the union
    .documentRetriever(VectorStoreDocumentRetriever.builder()
        .vectorStore(vectorStore)
        .similarityThreshold(0.5)
        .topK(4)
        .build())
    // 4. Post-retrieval: Jev drops bad passages, then reranks and keeps the top 3
    .documentPostProcessors(
        JevDocumentFilter.builder(typeSafeClient).build(),
        JevDocumentReranker.builder(typeSafeClient).topK(3).build())
    // 5. Generation: stuff the surviving context into the prompt
    .queryAugmenter(ContextualQueryAugmenter.builder()
        .allowEmptyContext(true)
        .build())
    .taskExecutor(taskExecutor)   // see "Things to know" below
    .build();
การใช้มันให้ความรู้สึกเหมือนกับที่ปรึกษาอื่น ๆ :
String answer = chatClient.prompt()
    .advisors(modularRag)
    .user("I'm a Florida resident and heard a lot about storms last fall. "
        + "Did Milton actually make landfall in my state, and where?")
    .call()
    .content();
DocumentRetriever และ DocumentPostProcessor มันเป็นอินเทอร์เฟซแบบวิธีเดียว ดังนั้นหนึ่งแลมบ์ดาก็เพียงพอที่จะบันทึกสิ่งที่ไหลผ่านไปป์ไลน์ การสาธิตเกี่ยวข้องกับรีทรีฟเวอร์และเพิ่มตัวประมวลผลหลังการพิมพ์สองตัวในขั้นตอน Jev นี่คือที่มาของผลลัพธ์ด้านล่างนี้
เจฟอยู่ในช่วงหลังฟื้นตัว
คอมโพเนนต์ทั้งสองส่งการโทร Jev ต่อการผ่าน โดยมีการสืบค้นและส่งผ่านเป็น สถานะและเปลี่ยนคำตอบให้เป็นการตัดสินใจ
JevDocumentFilter คำถามที่สี่ Noul คำถามเกี่ยวกับแต่ละตอนและนำไปใช้ตามลำดับ:
| คำถาม | ขีดจำกัดเริ่มต้น | ผลลัพธ์ |
|---|---|---|
contains_prompt_injection |
ข้างบน 0.70 |
ลบแล้ว |
contradicts_query_premise |
ข้างบน 0.70 |
บำรุงรักษาทำเครื่องหมาย CONFLICTING |
is_relevant |
ด้านล่าง 0.45 |
ลบแล้ว |
contains_answer_evidence |
ข้างบน 0.55 |
เก็บรักษาไว้มิฉะนั้นจะถูกลบออก |
นี่คือแนวคิดคำถามอะตอมจากบทความที่แล้วในที่ทำงาน: คำถามแคบสี่ข้อ ขีดจำกัดสี่ข้อ และการโทรหนึ่งครั้ง ข้อความที่ขัดแย้งกันยังคงอยู่โดยเจตนา หากผู้ใช้สันนิษฐานว่าเป็นเท็จ โมเดลควรเห็นหลักฐานที่กล่าวเช่นนั้น การจำแนกประเภทจะถูกจัดเก็บไว้ในข้อมูลเมตาของเอกสารใน jev.classificationและขีดจำกัดคือก Policy บันทึกที่คุณสามารถแทนที่ได้
JevDocumentReranker ถามคำถามเดียว ข้อความนี้สามารถตอบคำถามได้หรือไม่?จัดเรียงตามคะแนนและเก็บค่า K ไว้ คะแนนจะเข้าสู่ข้อมูลเมตาใน jev.rerank.score. คุณตั้งใจที่จะมุ่งเน้น: หากข้อความนำเสนอข้อมูลที่ตอบคำถาม ไม่ใช่แค่ครอบคลุมเรื่องเดียวกัน. นี่คือช่องว่างระหว่างความเหมือนและประโยชน์อย่างแท้จริง
การสั่งซื้อเป็นสิ่งสำคัญ กรองก่อน ดังนั้นตัวจัดประเภทใหม่จะจ่ายเฉพาะผู้รอดชีวิตเท่านั้น
การแข่งขันสด
การเขียนใหม่และการขยายเปลี่ยนวลีที่ช่างพูดเป็นการค้นหาที่มุ่งเน้นสี่ประการ:
[retrieve] Hurricane Milton 2024 Florida landfall location
[retrieve] Hurricane Milton track path across Florida from Gulf Coast to Atlantic and National Hurricane Center landfall report
[retrieve] Siesta Key Sarasota County Milton landfall timeline, storm surge, and areas impacted
[retrieve] Where did Hurricane Milton make landfall in Florida in October 2024 and at what intensity
ช่างไม้ได้รวมผลลัพธ์ของเขาออกเป็นหกส่วนที่ไม่เหมือนใคร โดยทั้งหมดอยู่เหนือ 0.5 เกณฑ์ความคล้ายคลึงกัน:
[retrieved] 0.84  Hurricane Milton ...
[retrieved] 0.72  6. "Hurricane Milton Makes Landfall On Florida's West Coast ...
[retrieved] 0.70  Hurricane Milton's landfall" (
[retrieved] 0.69  Archived (http ...
[retrieved] 0.59  /news/tropical-storm-milton-forms-gulf-of-mexico ...
[retrieved] 0.54  of Key West. [128] Across the state, about 125 homes were d...
สี่รายการคือรายการอ้างอิงและลิงก์ไฟล์ พวกเขาพูดถึงมิลตันบ่อยและไม่โต้ตอบเลย JevDocumentFilter ยกเว้นพวกเขาเนื่องจากขาดหลักฐานการตอบสนองและ JevDocumentReranker ทำเครื่องหมายผู้รอดชีวิตทั้งสอง:
[jev-reranked] 0.97  Hurricane Milton ...
[jev-reranked] 0.88  6. "Hurricane Milton Makes Landfall On Florida's West Coast ...
แล้ว topK(3) ส่งคืนเพียงสองชิ้นเท่านั้นและนั่นคือประเด็น โมเดลได้รับบริบทน้อยลง ทุกอย่างที่เกี่ยวข้อง:
Yes. Hurricane Milton made landfall in Florida, near Siesta Key, on the evening of
October 9, 2024. It had weakened to a Category 3 hurricane by then.
คำตอบความคล้ายคลึงกันของเวกเตอร์ “ข้อความนี้เกี่ยวกับอะไร?”. เจฟตอบกลับ “ข้อความนี้ตอบคำถามได้หรือไม่”. ไปป์ไลน์ RAG ต้องการทั้งสองอย่าง
⚠️เรื่องน่ารู้
ตัวรันเริ่มต้นจะรักษาแอปพลิเคชันบรรทัดคำสั่งที่ใช้งานอยู่
RetrievalAugmentationAdvisorดำเนินการดึงข้อมูลแบบสอบถามบนกลุ่มเธรดของตัวเอง และเธรดเหล่านี้ไม่ใช่เธรด daemon การสาธิตพิมพ์คำตอบแล้ววางสาย ผ่านการกำหนดค่าอัตโนมัติของ Spring BootTaskExecutorผ่าน.taskExecutor(...)แก้ไขสิ่งนี้และด้วยspring.threads.virtual.enabled=trueคุณจะได้รับเธรดเสมือนจริงฟรีโมเดลล่าสุดของ Claude ปฏิเสธ
temperature. เอกสาร Spring AI แนะนำอุณหภูมิ 0 สำหรับหม้อแปลงแบบสอบถามclaude-sonnet-5-5ตอบสนองต่อสิ่งนี้ด้วย HTTP 400 ดังนั้นการสาธิตจะโคลนตัวสร้างเพียงเพื่อป้องกันไม่ให้ที่ปรึกษาของลูกค้าหลักไม่ต้องเขียนซ้ำและขยายส่วนประกอบ Jev ทั้งสองไม่สามารถเปิดได้ หากไม่สามารถเข้าถึง Jev API ได้ ให้ส่งผ่านโดยไม่ต้องคัดกรองหรือให้คะแนน และคำเตือนจะถูกบันทึกไว้ ไปป์ไลน์ของคุณลดระดับลงเป็น RAG แบบโมดูลาร์ธรรมดาแทนที่จะพัง
อิฐแต่ละก้อนมีค่าใช้จ่ายในการตอบสนอง ไปป์ไลน์นี้เพิ่มการเรียก LLM สองครั้งก่อนการกู้คืนและการเรียก Jev หนึ่งครั้งต่อบล็อกที่ได้รับการกู้คืนหลังจากนั้น การเรียก Jev จะดำเนินการครั้งละสี่ครั้งตามค่าเริ่มต้น (
batchOptions(...)เปลี่ยนสิ่งนี้) แต่กรุณาวัดขนาดก่อนจัดส่ง
บทสรุป
Modular RAG เปลี่ยนการดึงข้อมูลจากที่ปรึกษาแบบทึบเป็นไปป์ไลน์ที่คุณสามารถอ่าน บันทึก และเปลี่ยนแปลงทีละชิ้นได้ ข้อมูลเชิงลึกที่สำคัญมีดังนี้:
- ตอบคำถามก่อนค้นหา การเขียนซ้ำบวกสามรูปแบบพบว่าบิตที่ดีกว่าประโยคดิบ
- แก้ไขผลลัพธ์ก่อนสั่งซื้อ ความคล้ายคลึงกันพบหกเรื่องเกี่ยวกับมิลตัน เจฟบันทึกทั้งคำตอบและสแกนแต่ละข้อความเพื่อฉีดยาทันที
- กรองและจัดประเภทใหม่ ทั้งสองมีค่าใช้จ่ายการโทรหนึ่งครั้งต่อรอบ ดังนั้นให้ตัวกรองจำกัดรายการให้แคบลงก่อน
คุณสมบัติ
สาธิต
05-1-modular-rag– รหัสในบทความนี้05-rag– ไร้เดียงสาQuestionAnswerAdvisorรุ่นสำหรับการเปรียบเทียบ
สปริงไอโอวา
สปริง AI TypeSafe
บทความที่เกี่ยวข้องกับ Spring AI
About the Author